martes, 26 de abril de 2016

Desarrollo Agil: ¿Qué es ser ágil?

¿Qué es ser ágil?

La palabra ágil fue asociada con el desarrollo de software en 2001 cuando el Manifiesto Ágil fue escrito por un grupo de visionarios y líderes en desarrollo de software [Stephen Haunts 2015]. Este manifiesto es la base pilar que tiene cuatro valores como cualidades que consideramos valiosas o deseables tener en cuenta para ser ágil. En consecuencia, ser ágil es adherir a estos valores y a sus principios, o sea al manifiesto y actuar acorde a ello [Walter Bodwell 2009][Stephen Haunts 2015].

What Is to be Agile? "To be agile, you need to adhere to the Agile Manifesto…As long as you're sticking to the Agile Manifesto's values and principles and delivering high-value software regularly to your customers, you should be considered Agile." [Stephen Haunts 2015]

Un valor es lo que tu pones delante de otra cosa cuando decides algo. No es difícil tomar decisiones cuando sabemos cuales son nuestros valores (Roy Disney). Por tal motivo, si somos conscientes de nuestros valores ágiles tomaremos decisiones alineadas a ellos. Nuestros valores tienen una gran determinación sobre nuestros resultados. En consecuencia, nuestra praxis ágil dependerá de nuestra mentalidad, de nuestro “mindset”.

Desde esta perspectiva, ser ágiles es que seamos conscientes de estos valores y que los tenemos presente en el día a día; que reflexionamos en el trabajo diario si actuamos acordes a ellos, si estamos convencidos de sus fundamentos, si comprendemos su alcance y cómo los aplicamos cuando resolvemos problemas o hacemos nuestra labor diaria.

Los valores ágiles expresados en el manifiesto ágil reordenados son los siguientes:
  1. Individuos e interacciones, sobre procesos y herramientas.
  2. Colaboración con el cliente, sobre negociación contractual.
  3. Respuesta ante el cambio, sobre seguir un plan.
  4. Software funcionando sobre, documentación extensiva.

[Agilemanifesto 2001]

Referencias:

[Agilemanifesto 2001] Agilemanifesto.org, 2001. URL: http://agilemanifesto.org/iso/es

[Stephen Haunts 2015] Agile Software Development Succinctly By Stephen Haunts Foreword by Daniel Jebaraj. 2015 by Syncfusion, Inc. Courtney Wright.

[Walter Bodwell 2009] What Is Agile? by Walter Bodwell, wbodwell on Sun (wbodwell's blog), 09/27/2009. (URL: http://www.walterbodwell.com/what_is_agile)

[dosideas.com 2009] Qué significa ser ágil. URL: http://www.dosideas.com/noticias/reflexiones/732-ique-significa-ser-agil.html


[Scrumalliance 2016] What Is Agile?


martes, 29 de marzo de 2016

SCRUM, Desarrollo de Software: Leyes del desarrollo de software


Leyes del desarrollo de software que todo Scrum Master debería conocer:


  1. Tetraedro de oro: El cliente no puede controlar todos los vértices del triángulo de gestión de proyectos.
  2. Ley de Parkinson: las necesidades se expanden hasta consumir todos los recursos. Una tarea dura más de lo que se espera. El trabajo se expande hasta llenar el tiempo disponible hasta que se termine.
  3. Hay que vivir con la incertidumbre. Se es incapaz de estimar bien.
  4. Regla 80/20 de Pareto: el 20% de una acción produce el 80% de los efectos. El 20% del código genera el 80% de bugs. El 20% de la funcionalidad resultará en el 80% del valor. El 20% de usuarios usará el 80% de la funcionalidad.
  5. Ley de Brooks: añadir más personas a un proyecto de software en retraso lo retrasará más.
  6. Ley de Humphrey: “Lo sabré cuando lo vea”. Semejante a un principio de Henry Ford: "Con frecuencia, el cliente no sabe lo que quiere hasta que lo ve" (seguida por Steve Jobs).
  7. Ley de Ziv: “El desarrollo del software es impredecible y los requisitos nunca serán completamente comprendidos”
  8. Leye de Lehman: “Cambio continuo: Un sistema debe ser continuamente adaptado o será cada vez menos satisfactoria para sus usuarios”. Es un principio de degradación: Si no dejamos espacio para que el sistema mejore el mismo empeora. Si no se planifica el mantenimiento o la mejora, el sistema empeora.
  9. La curva J: “Ninguna mejora es fácil”. Se desprende del principio de complejidad creciente: La complejidad crece salvo que se trabaje para reducirla. La simplicidad requiere esfuerzo.
  10. No existe la bala de plata: “Las herramientas y técnicas no funcionan tanto”.
  11. Ley de las fugas de absctracción: “Toda abstracción fuga detalles”.
  12. Mantener informado al cliente: “Los clientes prefieren las malas noticias a las sorpresas”.
  13. El costo de la no calidad es muy caro. La calidad no debera ser opcional.


Referencia:
Rodrigo Corral - Leyes del desarrollo de software que todo Scrum Master debería conocer (https://www.youtube.com/watch?v=vPtBB-zU0X0)

lunes, 22 de febrero de 2016

SCRUM: Release Planning y Scrum

Scrum y el Release Planning


¿Qué es un Release Plan?


Un "Release Plan" o plan de entregas es un conjunto de historias de usuario (normalmente épicas) agrupadas por "releases" o versiones del producto que se ponen a disposición de los usuarios (jmbeas, 2011). Es una planificación a media distancia como una proyección hacia adelante en una serie de sprints (Mike Cohn, 2012).


El Release Planning no es parte de Scrum

 
El “Release Planning” es una planificación de entregas algo valiosa de hacer cuando se usa el marco Scrum, pero no es requerido por el "núcleo Scrum" o el "Scrum originario" (Scrum.org, 2011) (David Bulkin, 2011). Se puede utilizar Scrum con éxito sin necesidad de utilizar Release Planning. Por este motivo es valioso comprender cuando puede usarse uno y cuando no.


¿Por qué no usarlo?


Puede no usarse simplemente porque no es parte de Scrum originario (determinado por los autores Ken Schwaber y Jeff Sutherland, Scrum Guide de Scrum.org y Scrum Atlas/Guide de Scrum Alliance) y no es necesario para usar Scrum satisfactoriamente.


Cuando Scrum se utiliza bien el valor potencial se crea en cada Sprint, pero si el incremento no se libera con cada Sprint o no es potencialmente utilizable, no estamos cumpliendo con el objetivo dentro del marco Scrum originario. O sea que, bajo este marco, estamos destinados a ofrecer valor operativo a los clientes de forma continua a través de iteraciones cortas. En este sentido, utilizar Release Planning puede formalizar el retraso de entrega de valor o malas prácticas. Las malas prácticas pueden ser las siguientes:

  • El equipo no es capaz de crear incrementos realmente utilizable y el Release Planning afianza las prácticas de desarrollo pobre.
  • Los procesos para liberar incremento utilizable son muy engorrosos, burocráticos y lentos que exigen una planificación. En este caso, el Release Planning puede colaborar en mantener estos procesos pesados en vez de procurar modificarlos para hacerlos más ágiles.

¿Por qué sí usarlo?


El Release Planning puede ser de gran utilidad bajo determinadas circunstancias.

  • Cuando es difícil ofrecer una solución empresarial compleja en corto período de tiempo de un solo Sprint o se necesitan extensos períodos de prueba para satisfacer los requisitos de alta calidad (Scrum.org, 2011). Puede ser útil planificar releases o liberar un paquete de historias cuando las mismas tienen dependencias entre sí y aportan realmente valor cuando se las liberan juntas.
  • A veces los clientes no quieren liberaciones frecuentes, ya que pueden crear más problemas o ruido en el mercado (Scrum.org, 2011). En ocasiones y por estrategia de negocio es conveniente planificar lanzamientos.
  • Ayuda a la transparencia permitiendo comunicar las expectativas sobre lo que se puede desarrollar y en qué tiempo aproximado, lo cual, esto ayuda a que el resto de la organización pueda hacerse una idea del desarrollo y progreso (jmbeas, 2011). Este plan de aproximación para dar visibilidad "nunca debe ser tratado como un compromiso contractual ni como herramienta de presión al equipo".
  • Puede servir tener un criterio de aceptación para cada “release” y asi preveer dependencias y detectar riegos (jmbeas, 2011). Puede ayudar en equipos con interdependencias y en la necesidad de coordinar entre ellos (Kent McDonald, 2013).
  • Sirve, en la agilidad, como mapa topográfico que permite trazar una ruta hacia el objetivo del proyecto y así ayudar al equipo en el desarrollo ágil (Mike Cohn, 2009).


¿Por qué algunos lo usan como parte obligatoria de una metodología ágil?


Hay organizaciones que siguen una metodología basada en Scrum distinta a la ortodoxa u originaria, como la señalada por el SBOK de VMEdu, con ella se ve útil la necesidad de planificar. Por lo general se asocia a metodologías u organizaciones con cierta afinidad al PMI. Por ejemplo, para el SBOK el Release Planning se hace en el proceso de inicio de un proyecto o "Conduct Release Planning", es necesario para hacer "Release Planning Schedule" que es un input obligatorio de "Ship Deliverables" y es responsabilidad del Product Owner. El mismo es parte de la planificación inicial del proyecto y ayuda a clarificar nuevos productos o cambios en los productos existentes. O sea que en este caso el Release Plan es parte constitutiva de la metodología.


Notas:
  • El SBOK es impulsado por PMstudy que es un brand of VMEdu, Inc., el cual es un PMI® approved R.E.P. (it is allowed to display the PMI® logo on its website and also provide PMI® approved "Contact Hour" certificates to students). El libro SBOK fue escrito por una treintena de personas, ninguno de los cuales están activos en el ámbito oficial de Scrum o la comunidad ágil y parece que no fue sancionada por ningún miembro oficial de la comunidad Scrum. De hecho Ken Schwaber lo rechaza y dice que Tridibesh Satpathy, autor de SBOK, quita el corazón, el alma y los valores de Scrum con este libro (Don Kim, 2016).

¿Cómo hacer un Release Plan minimalista?


Hay que tener en cuenta que bajo el marco Scrum el Release Plan, si se hace, debe ser un documento minimalista (simple), abierto a modificaciones constante y transparentado o consensuado con el equipo de desarrollo o desarrollado con el mismo.

Para hacer un Release Plan minimalista es necesario identificar historias del MVP que representan el camino crítico (o mínimo para tener un sub-producto funcional de valor para cliente de cara a público), identificar dependencias y riesgos; y planificar fechas o Sprints de releases.

Además, como requisitos, es necesario tener un Product Backlog refinado (estimado y priorizado), saber la velocidad del equipo y las condiciones de satisfacción (metas para la programación, alcance , recursos) (Scrum-institute.org, 2016).

A continuación puedo mostrar un ejemplo:

Release Plan Ejemplo


Objetivo:

Este Release Plan es un documento que presenta un conjunto de historias de usuario agrupadas por sprint y releases, que se ponen a disposición de los usuarios y que conforman el MVP (sub-producto mínimo) del proyecto. Es una planificación a media distancia como una proyección hacia adelante en una serie de sprints. Este documento ayuda a brindar transparencia permitiendo comunicar las expectativas sobre lo que se puede desarrollar de aquí a X sprints. Hay que tener en cuenta que esta aproximación para dar visibilidad nunca debe ser tratada, dentro del marco ágil de trabajo, como un compromiso contractual.

Agenda de entrega

La agenda estimada es la siguiente:


Riesgos:

Identificar los riesgos principales.


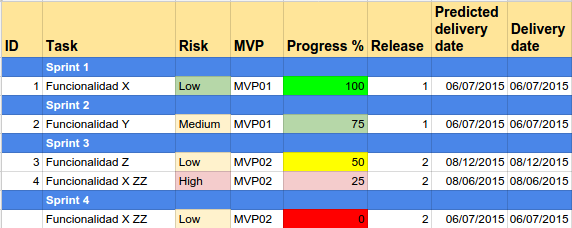
Otro ejemplo de release plan

En proyectos grandes se pueden usar features, en vez de historias, como un grado más de abstracción útil para reportar al Management sin el detalle y granularidad de historias e story points.
Una manera es listar las features (que pueden ser funcionalidades de alto nivel que engloban o contienen un conjunto de historias), a qué MVP corresponde (que es como una categoría más alta, semejante a épica), riesgo (grado de incertidumbre o riesgos), progreso (status), release (puede ser el número de release), y fechas estimadas y de release real.


Referencias:


(Scrum.org, 2011) Article: “Gone are Release Planning and the Release Burndown”, By Ralph Jocham and Henk Jan Huizer in Community Publications, Scrum.org, Saturday, October 01, 2011.
URL: https://www.scrum.org/About/All-Articles/articleType/ArticleView/articleId/17/Gone-are-Release-Planning-and-the-Release-Burndown

(David Bulkin, 2011) Article: "Ken Schwaber and Jeff Sutherland Release Updated Scrum Guide". By David Bulkin, Infoq.com on Jul 27, 2011.
URL: http://www.infoq.com/news/2011/07/UpdatedScrumGuide

(Don Kim, 2016) Article: The SBOK? Looks like anyone can create a PM standard these days!, By Agility and Project Leadership Blog by Don Kim.
URL: http://www.projectmanagement.com/blog/Agility-and-Project-Leadership/7084/

(Mike Cohn, 2009) Why Do Release Planning? April 11, 2009  by Mike Cohn.
URL: https://www.mountaingoatsoftware.com/blog/why-do-release-planning

(Mike Cohn, 2012) Release Planning: Retiring the Term but not the Technique.
Mike Cohn, 2012.
URL: https://www.mountaingoatsoftware.com/blog/release-planning-retiring-term-not-technique

(jmbeas, 2011) Articulo: Release plan (o plan de proyecto), jmbeas, 2011. Bibliografía: “Agile Estimating and Planning” de Mike Cohn.Release plan (o plan de proyecto)
URL: http://jmbeas.es/guias/release-plan/

(Kent McDonald, 2013) How to Do Agile Release Planning. By Kent J. McDonald - March 1, 2013.
URL: https://www.techwell.com/techwell-insights/2013/03/how-do-agile-release-planning

(Scrum-institute.org, 2016) SCRUM RELEASE PLANNING, scrum-institute.org, 2016.
URL: http://www.scrum-institute.org/Release_Planning.php


miércoles, 18 de noviembre de 2015

SCRUM: StoryPoints de Historias No aprobadas Vs CarryOver

StoryPoints de Historias No aprobadas

Hay algunas preguntas que surgen relacionado a historias no aceptadas, alejadas de SCRUM, que tienen como respuesta diferentes estrategias. Ellas son:

¿Qué hacer con los puntos gastados en la historia rechazada?
¿Los puntos gastados quedan como capacity y/o se arrastran al próximo sprint para que figuren en la prómxima velocity?
¿Son puntos perdidos de la velocity o se suman a una próxima velocity?


Aquí surge el concepto de Carryover...

Carryover


El Carry Over es una User Story Comprometida y No Aceptada por el Cliente en la Demo/Review al final del Sprint. En otras palabras, es la historia no finalizada y acarreada de un sprint a otro (Kell Condon, 2015).

Estrategia 1:

El carryover conlleva puntos perdidos (Kell Condon, 2015). La velocidad debe bajar porque el equipo no fue capaz de entregar trabajo "Done" aceptado. Son puntos perdidos de la velocity actual y no se suman a una próxima velocity (ya que la velocity refleja carrera real actual de sprint y no vale sumar puntos que realmente no se hicieron en la carrera). Los puntos quemados de la historia no se arrastran ni se contabilizan en el futuro. La historia pasa al backlog para ser reestimada para ser tomada en próximos sprint. Solo se reestima el trabajo restante, cuando se toma la historia en una planning, o lo que quede por hacer si se pudo recuperar algo de lo hecho.
En esta estrategia no es necesario manejar el concepto de carryover.

Estrategia 2:


El carryover genera puntos arrastrados que contabilizan para velocity futura, o sea que los puntos quemados de la historia se arrastran y se contabilizan en el futuro (Kell Condon, 2015). La historia pasa al backlog para ser reestimada y ser tomada en próximos sprint. Solo se reestima el trabajo restante, cuando se toma la historia en una planning, o lo que quede por hacer si se pudo recuperar algo de lo hecho y se suma a lo acarreado. O sea que se reestima el SP Remanente, o sea los SP que restan para terminar esta US. Por ejemplo si se quemaron 3 SP (en sprint previo) y faltan 2 SP (de la Reestimación), la historia pesará 5 SP (Tamaño real de la US).


Referencia:

- (Kell Condon, 2015) Article, "Pick A Side: How to handle sprint carry over":

http://requirements.seilevel.com/pick-a-side-how-to-handle-sprint-carry-over

lunes, 21 de septiembre de 2015

Perl: Pairing in Pair programming without repeated

Script para formar parejas sin repetición de pares para pairing


#!/usr/bin/perl -s
# Perl Scrip to Pairing in Pair programming
# Example:

# La primera vez llamar con argumentos:
# perl pairing.pl "Dario" "Gaby" "Claudio" "Frula" "Ricardo" "Raul" "Esteban" "Adrian" 

# A partir de la segunda vez llamar sin argumentos porque los nombres fueron guardados en un archivo.
# perl pairing.pl
   
use strict;
use warnings;


# Begin main

# @ARGV is a array of command line arguments
if (scalar @ARGV == 0){
    # File input. Read from file
    my @input_argv = @{read_array_from_file('file_example.txt')};
    do_pairing_no_repeated(\@input_argv);
    }elsif (scalar @ARGV > 3){
        #ARG input. Read from arguments of command line
        do_pairing_repeated(\@ARGV);
        }else{
            print "Arguments must be more than 3! \n";
        }

# End main

# Run pairing with repeated
sub do_pairing_repeated{
    my ($ARGV) = @_; #array reference
   
    my @pairing_list=();
    do_pairing($ARGV, \@pairing_list);
    print_pairing(\@pairing_list);
    save('file_example.txt', \@pairing_list);
}

# Run pairing NO repeated
sub do_pairing_no_repeated{
    my ($ARGV) = @_; #array reference
    my $no_repeated=1;
    my @pairing_list;
    do{
        @pairing_list=();
        do_pairing($ARGV, \@pairing_list);
        $no_repeated = compare_if_no_repeated($ARGV, \@pairing_list);
    } until($no_repeated);
    print_pairing(\@pairing_list);
    save('file_example.txt', \@pairing_list);
}

# Checks if couples are repeated in the two arrays
sub compare_if_no_repeated{
    my ($origin_list, $pairing_list) = @_; #array reference
   
    for(my $i=0; $i<=scalar @{$origin_list} - 1; $i = $i + 2){
       
        if ($i < scalar @{$origin_list} - 1) {
            if (are_repeated(@{$origin_list}[$i], @{$origin_list}[$i + 1], @{$pairing_list}[$i], @{$pairing_list}[$i + 1])){
                return 0;
                }
           
            }
    }    
    return 1;
}

# Checks if the two pairs are the same (repeated pairs)
sub are_repeated{
    my ($pair_1_a, $pair_1_b, $pair_2_a, $pair_2_b) = @_;
   
    if (($pair_1_a eq $pair_2_a) && ($pair_1_b eq $pair_2_b)){
        return 1
        }
    if (($pair_1_a eq $pair_2_b) && ($pair_1_b eq $pair_2_a)){
        return 1
        }
    return 0;
}

# Print pairing names from a members array
sub print_pairing{
    my ($members) = @_; #array reference
   
    for(my $index=0; $index<=scalar @{$members} - 1; $index = $index + 2){
        print @{$members}[$index] . "-";
        if ($index < scalar @{$members} - 1) {
            print @{$members}[$index + 1] . "\n";
            }else{
                print "none \n";
                }
    }    
}

# Run pairing
sub do_pairing{
    my ($members, $pairing_list) = @_; #array reference

    my @members_copy;
   
    foreach my $elem (@{$members}) {
        push (@members_copy, $elem);
    }
   
    my $members_count = scalar @members_copy;
    do{
        my $selected =  get_member_and_remove_it_random(\@members_copy);
        $members_count = $members_count - 1;
        push (@{$pairing_list}, $selected);
       
    } until($members_count==0);
}

# Retrieves a member and removes it from the array.
sub get_member_and_remove_it_random{
    my ($members) = @_; #array reference
    my $size = scalar @{$members};
    my $random_number = int(rand($size));
    my $removed_member =  splice @{$members}, $random_number, 1;
    return $removed_member;
}

sub read_array_from_file{
    my ($filename) = @_;
    my @input_array = ();

    if (open(my $fh, '<:encoding(UTF-8)', $filename)) {
        while (my $row = <$fh>) {
            chomp $row;
            push (@input_array, $row);
        }
    } else {
        warn "Could not open file '$filename' $!";
        }
    return \@input_array;
}

sub save{
    my ($filename, $array_reference) = @_;
   
    open(my $fh, '>:encoding(UTF-8)', $filename) or die "Could not open file '$filename' $!";
   
    foreach my $elem (@{$array_reference}) {
        print $fh "$elem\n";
    }

    close $fh;
}

miércoles, 9 de septiembre de 2015

Perl: Pairing in Pair programming

Script para formar parejas para programación de a pares


#!/usr/bin/perl -s
# File: pairing.pl 
# Perl Scrip to Pairing in Pair programming
# Command line example:
# perl pairing.pl "Dario" "Karina" "Claudia" "Pancho"

  
use strict;
use warnings;

# Begin main
# @ARGV is a array of command line arguments
if (scalar @ARGV > 0){
    runPairing(\@ARGV);
}else{
    print "No arguments. Enter names. For example: \n";
    print "perl pairing.pl \"name1\" \"name2\" \"name3\" \"name4\" \n";
    }

# End main


# Run pairing
sub runPairing{
    my ($members) = @_; #array reference
    my $members_count = scalar @{$members};
    my $pair_count = 1;
    do{
        my $first_selected =  getMemberAndRemoveItRandom($members);
        $members_count = $members_count - 1;
        if ($members_count > 0){
            my $second_selected =  getMemberAndRemoveItRandom($members);
            $members_count = $members_count - 1;
            print "Pair $pair_count: " . $first_selected;
            print " - " . $second_selected . " \n";
            }else{
                print "Pair $pair_count: " . $first_selected . " - none\n";
                }
        $pair_count = $pair_count + 1;
    } until($members_count==0);
}

# Retrieves a member and removes it from the array.
sub getMemberAndRemoveItRandom{
    my ($members) = @_; #array reference
    my $size = scalar @{$members};
    my $random_number = int(rand($size));
    my $removed_member =  splice @{$members}, $random_number, 1;
    return $removed_member;
}


viernes, 24 de julio de 2015

SVN: Ancestrally problem or How to copy branch to trunk


Cómo solucionar el problema de tratar de generar el trunk cuando se partó a trabajar en una rama directamente y no desde el trunk.

PROBLEMA:


Se intenta mergear desde una rama (el código del proyecto está en una rama) cuando el trunk está vacío y el proyectos se creó desde la rama y no desde el trunk.

svn merge ^/branches/MyBranch/ --reintegrate
svn: 'https://svn.example.com/repos/MyRepo/branches/MyBranch@92' must be ancestrally related to 'https://svn.dev.example.com/repos/MyRepo/trunk@92'
dario.palminio@exampleglb-l1077:~/Workspace/reissuePrice_trunk$ svn merge ^/branches/MyBranch/
--- Merging r11 through r92 into '.':
   C doc
   C src
   C pom.xml
 U   .
Summary of conflicts:
  Tree conflicts: 3
dario.palminio@exampleglb-l1077:~/Workspace/reissuePrice_trunk$ ll


SOLUCIÓN:


Una solución es regenerar el trunk (que actualmente está vacío):

svn delete -m 'Borra el trunk para regenerarlo' https://svn.example.com/repos/MyRepo/trunk

svn copy -m 'Genera el trunk copiando desde el branche 1260' https://svn.example.com/repos/MyRepo/MyBranch https://svn.example.com/repos/MyRepo/trunk

Esto debería funcionar, pero si tira un error como el que sigue:
...svn: Path 'https://svn.example.com/repos/MyRepo/MyBranch' does not exist in revision 93

Se puede probar copiar la copia local al trunk (regenerándolo):

svn copy . https://svn.example.com/repos/MyRepo/trunk